Category: MultiAgentes de IA

  • Landing Page com n8n: Capture Leads no Google Sheets

    Landing Page com n8n: Capture Leads no Google Sheets

    Objetivo

    O objetivo deste artigo é apresentar como construir, do zero, uma landing page funcional de captura de leads utilizando apenas o n8n — sem precisar de servidor, hospedagem própria ou ferramentas pagas de landing page. A página é servida diretamente por um Webhook do n8n, e os dados preenchidos pelo visitante (nome, e-mail e WhatsApp) são validados e salvos automaticamente em uma planilha do Google Sheets, prontos para serem usados por times de vendas, marketing ou em campanhas de captação para eventos, mentorias e materiais gratuitos.

    Pré-requisitos

    Para seguir este roteiro você vai precisar de:

    1. Uma conta no n8n (Post da ValueHub explicando como criar sua conta, caso ainda não tenha).
    2. Uma conta Google com acesso ao Google Sheets e credencial OAuth2 configurada no n8n (nó Google Sheets).
    3. Noções básicas de HTML/JavaScript são úteis, mas não obrigatórias — o código já vem pronto neste artigo.

    Como o fluxo funciona

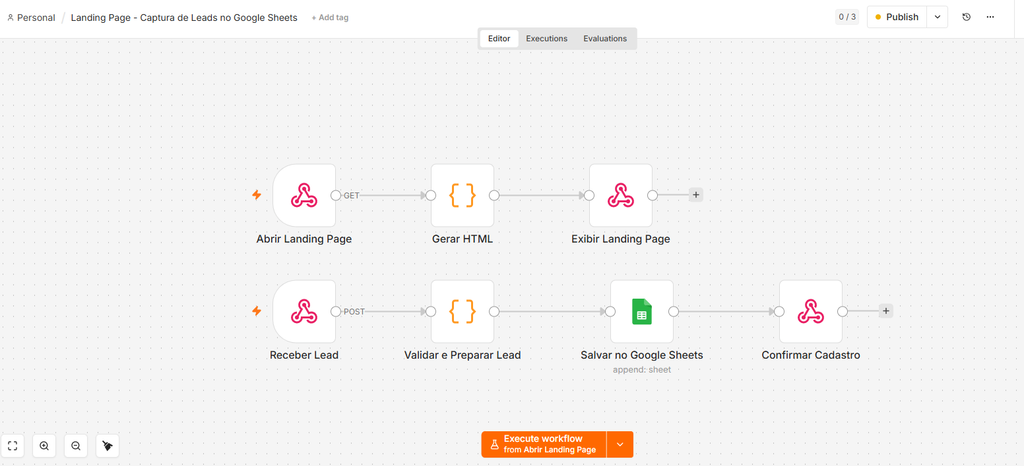
    O workflow é dividido em dois blocos independentes, conectados pelo próprio formulário da página:

    • Bloco 1 — Exibir a página: um Webhook (GET) responde com o HTML da landing page sempre que alguém acessa a URL.
    • Bloco 2 — Capturar o lead: um segundo Webhook (POST) recebe os dados enviados pelo formulário, valida as informações e grava uma nova linha no Google Sheets.

    Essa separação em dois webhooks é o que permite servir uma página completa (HTML, CSS e JavaScript) e, ao mesmo tempo, processar o envio do formulário sem sair do n8n.
    visão geral do workflow no n8n, com os dois blocos lado a lado

    Figura 1: visão geral do workflow no n8n, com os dois blocos lado a lado

    Configurando o Bloco 1 — Exibição da Landing Page

    Passo 1: Webhook de entrada (Abrir Landing Page)

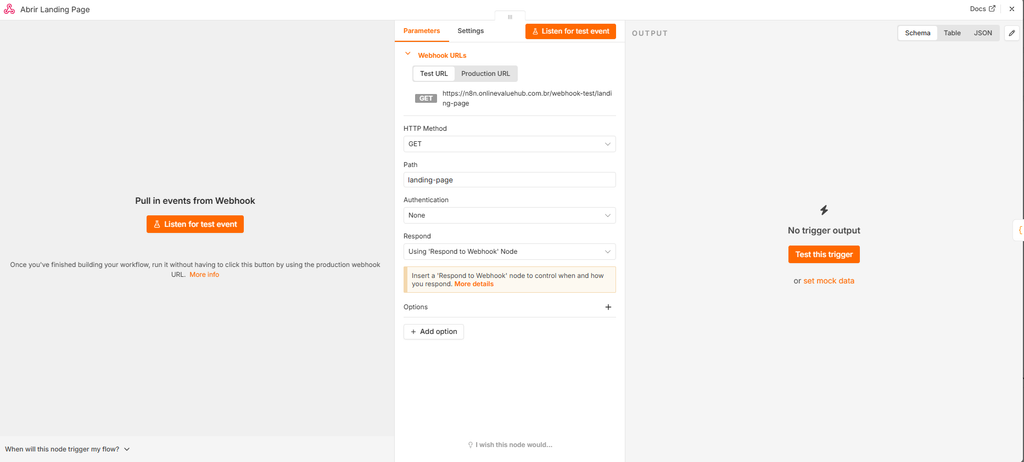
    • Adicione um nó Webhook.
    • HTTP Method: GET.
    • Path: landing-page (esse será o endereço público da sua página).
    • Response Mode: Using Response Node (a resposta será controlada por outro nó mais à frente no fluxo).
    nó Webhook configurado com HTTP Method GET e path landing-page

    Figura 2: nó Webhook configurado com HTTP Method GET e path landing-page

    Passo 2: Gerando o HTML (nó Code)

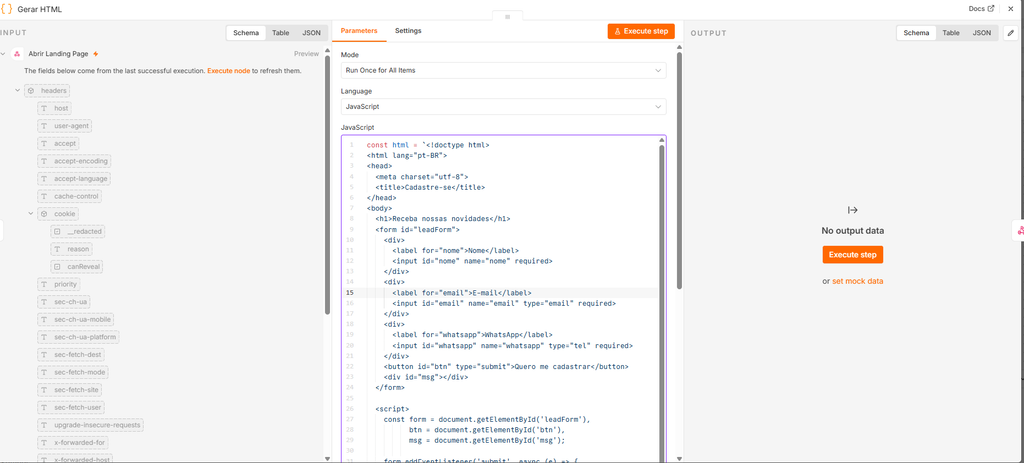
    • Adicione um nó Code logo após o Webhook.
    • Nele, é montada uma string HTML completa contendo:
      • Um formulário com os campos Nome, E-mail e WhatsApp;
      • Estilização própria (cores, tipografia e responsividade) direto em uma tag <style>;
      • Um script que intercepta o envio do formulário (submit), monta o payload em JSON e faz um fetch para o segundo Webhook (/webhook/capturar-lead), exibindo mensagens de sucesso ou erro para o usuário sem recarregar a página.

    Trecho essencial da lógica de envio no JavaScript da página:


    const html = `<!doctype html>
    <html lang="pt-BR">
    <head>
      <meta charset="utf-8">
      <title>Cadastre-se</title>
    </head>
    <body>
      <h1>Receba nossas novidades</h1>
      <form id="leadForm">
        <div>
          <label for="nome">Nome</label>
          <input id="nome" name="nome" required>
        </div>
        <div>
          <label for="email">E-mail</label>
          <input id="email" name="email" type="email" required>
        </div>
        <div>
          <label for="whatsapp">WhatsApp</label>
          <input id="whatsapp" name="whatsapp" type="tel" required>
        </div>
        <button id="btn" type="submit">Quero me cadastrar</button>
        <div id="msg"></div>
      </form>
    
      <script>
        const form = document.getElementById('leadForm'), 
              btn = document.getElementById('btn'), 
              msg = document.getElementById('msg');
    
        form.addEventListener('submit', async (e) => {
          e.preventDefault();
          btn.disabled = true;
          msg.textContent = 'Enviando...';
          
          try {
            const payload = Object.fromEntries(new FormData(form));
            const res = await fetch('/webhook/capturar-lead', {
              method: 'POST',
              headers: { 'Content-Type': 'application/json' },
              body: JSON.stringify(payload)
            });
            
            if (!res.ok) throw new Error('Erro');
            
            msg.textContent = 'Cadastro realizado com sucesso!';
            form.reset();
          } catch (err) {
            msg.textContent = 'Erro ao enviar. Tente novamente.';
          } finally {
            btn.disabled = false;
          }
        });
      </script>
    </body>
    </html>`;
    
    return [{ json: { html } }];

    Dica: como o HTML inteiro está dentro do nó Code, você pode personalizar cores, textos e campos do formulário sem precisar de nenhuma ferramenta externa — basta editar a string.
    nó Code com a string HTML da landing page

    Figura 3: nó Code com a string HTML da landing page

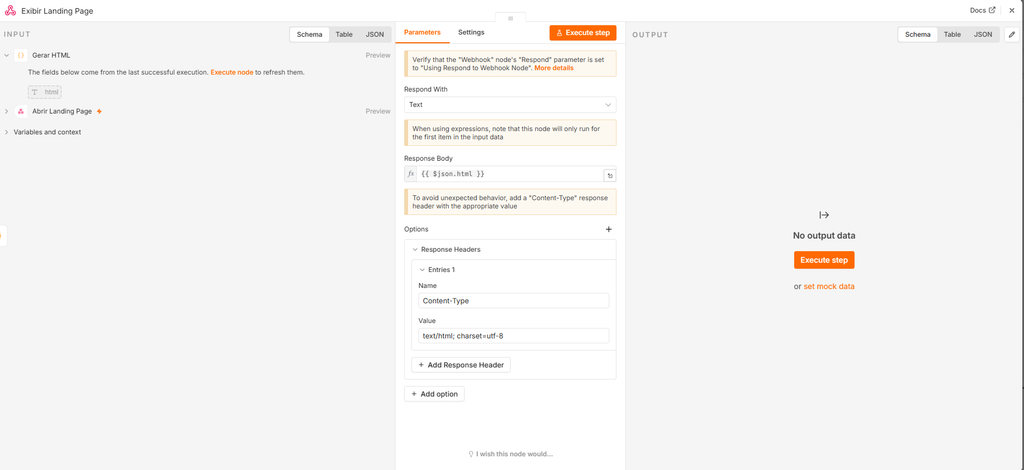
    Passo 3: Respondendo com a página (Exibir Landing Page)

    • Adicione um nó Respond to Webhook.
    • Respond With: Text.
    • Response Body: {{ $json.html }} (o HTML gerado no passo anterior).
    • Em Response Headers, adicione Content-Type: text/html; charset=utf-8 para o navegador renderizar a página corretamente.

    Com esses três nós, ao acessar a URL pública do Webhook (.../webhook/landing-page) o visitante já vê a landing page completa.
    landing page aberta no navegador pela URL do webhook

    Figura 4: landing page aberta no navegador pela URL do webhook

    Configurando o Bloco 2 — Captura e validação do lead

    Passo 4: Webhook de recebimento (Receber Lead)

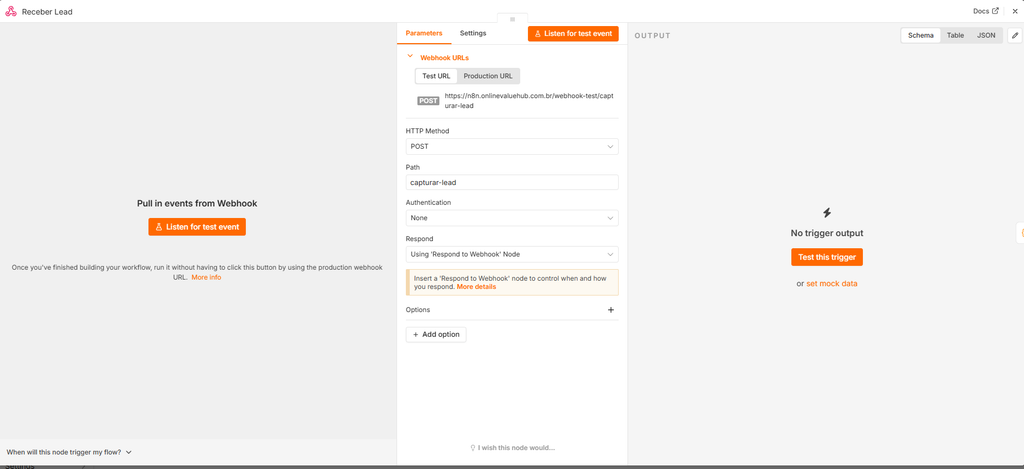
    • Adicione um segundo nó Webhook.
    • HTTP Method: POST.
    • Path: capturar-lead (é este endereço que o JavaScript da página chama no envio do formulário).
    • Response Mode: Using Response Node.
    nó Webhook POST com o path capturar-lead

    Figura 5: nó Webhook POST com o path capturar-lead

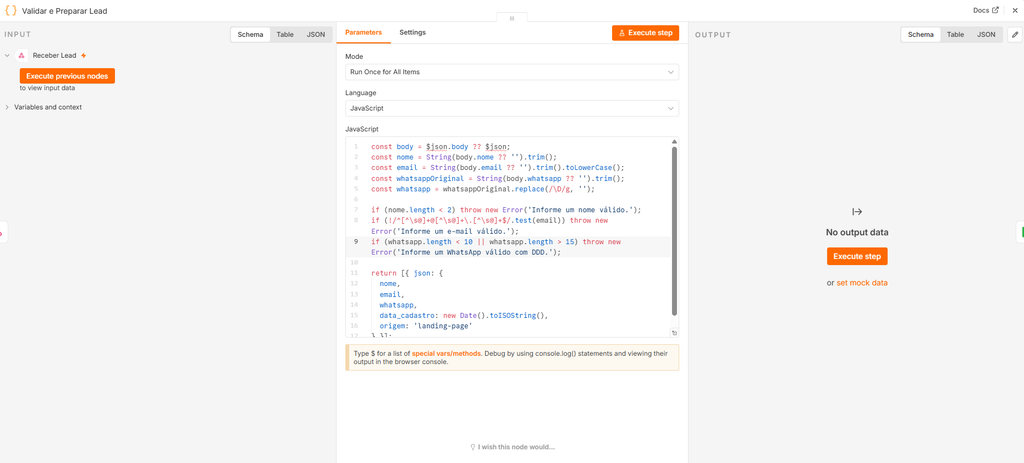
    Passo 5: Validando os dados (nó Code)

    Antes de gravar qualquer informação na planilha, o fluxo valida e normaliza os dados recebidos:


    const body = $json.body ?? $json;
    const nome = String(body.nome ?? '').trim();
    const email = String(body.email ?? '').trim().toLowerCase();
    const whatsappOriginal = String(body.whatsapp ?? '').trim();
    const whatsapp = whatsappOriginal.replace(/\D/g, '');
    
    if (nome.length < 2) throw new Error('Informe um nome válido.');
    if (!/^[^\s@]+@[^\s@]+\.[^\s@]+$/.test(email)) throw new Error('Informe um e-mail válido.');
    if (whatsapp.length < 10 || whatsapp.length > 15) throw new Error('Informe um WhatsApp válido com DDD.');
    
    return [{ json: {
      nome,
      email,
      whatsapp,
      data_cadastro: new Date().toISOString(),
      origem: 'landing-page'
    } }];

    Esse passo garante que:

    • Nome tenha pelo menos 2 caracteres;
    • E-mail siga um formato válido;
    • WhatsApp contenha apenas números e tenha um tamanho compatível com DDD + número;
    • Cada lead receba automaticamente uma data de cadastro e a origem do contato — útil quando você tiver mais de uma landing page alimentando a mesma planilha.

    Se qualquer validação falhar, o nó lança um erro que pode ser tratado para retornar uma mensagem amigável ao visitante.
    nó Code de validação com o script de normalização dos campos

    Figura 6: nó Code de validação com o script de normalização dos campos

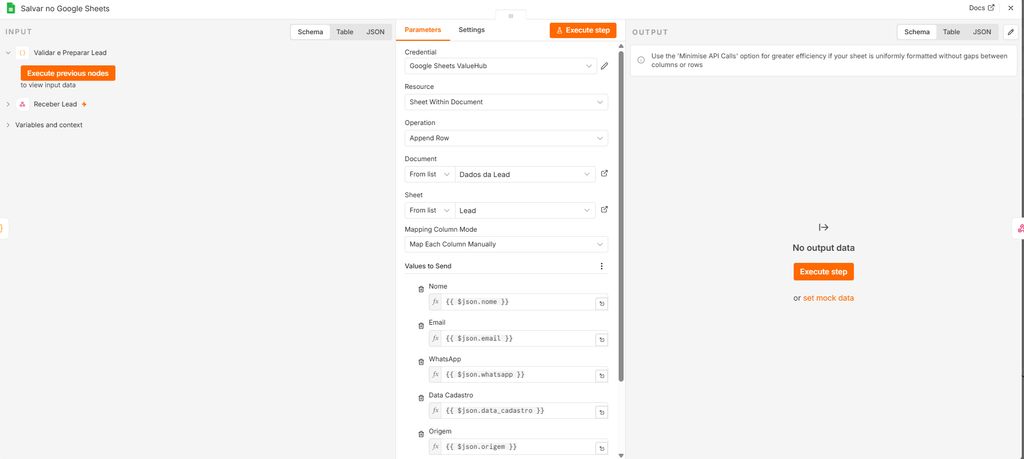
    Passo 6: Salvando no Google Sheets

    • Adicione o nó Google Sheets.
    • Credential: sua credencial OAuth2 do Google já conectada ao n8n.
    • Operation: Append.
    • Document: selecione a planilha de destino (ex: “Dados da Lead”).
    • Sheet: selecione a aba correspondente (ex: “Lead”).
    • Em Columns, mapeie:
      • Nome → {{ $json.nome }}
      • Email → {{ $json.email }}
      • WhatsApp → {{ $json.whatsapp }}
      • Data Cadastro → {{ $json.data_cadastro }}
      • Origem → {{ $json.origem }}

    Cada novo envio do formulário vira, automaticamente, uma nova linha na planilha.
    nó Google Sheets em modo Append com as cinco colunas mapeadas

    Figura 7: nó Google Sheets em modo Append com as cinco colunas mapeadas

    Passo 7: Confirmando o cadastro

    • Adicione um nó Respond to Webhook.
    • Respond With: JSON.
    • Response Body: {"success": true, "message": "Lead cadastrado com sucesso"}.
    • Response Code: 201.

    Esse é o retorno que o fetch da landing page recebe para exibir a mensagem de sucesso ao visitante.
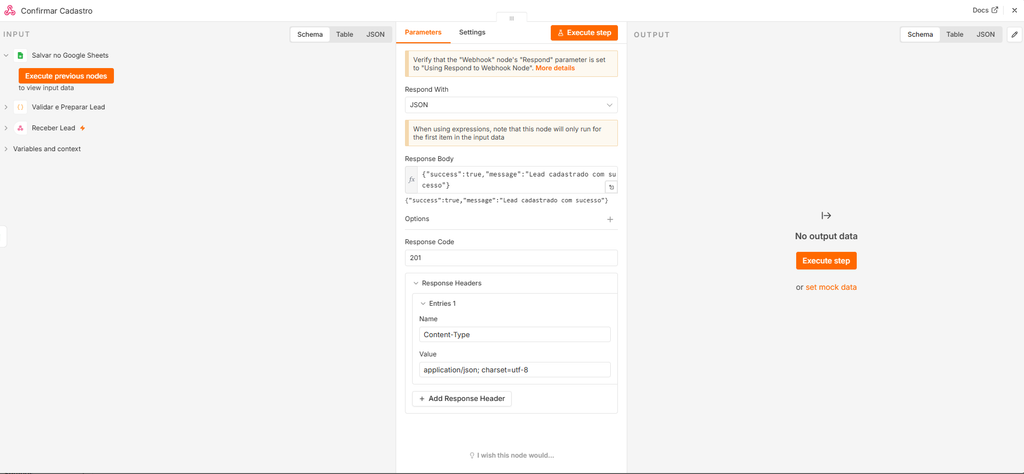
    Figura 8: nó Respond to Webhook devolvendo o JSON de sucesso com código 201

    Testando o fluxo

    1. Ative o workflow no n8n.
    2. Acesse a URL pública do Webhook landing-page no navegador — a página deve carregar normalmente.
    3. Preencha o formulário com nome, e-mail e WhatsApp e envie.
    4. Confira se a mensagem de sucesso aparece na tela e se uma nova linha foi criada na planilha do Google Sheets.
    5. Teste também os cenários de erro (e-mail inválido, campo vazio) para confirmar que as validações estão funcionando.
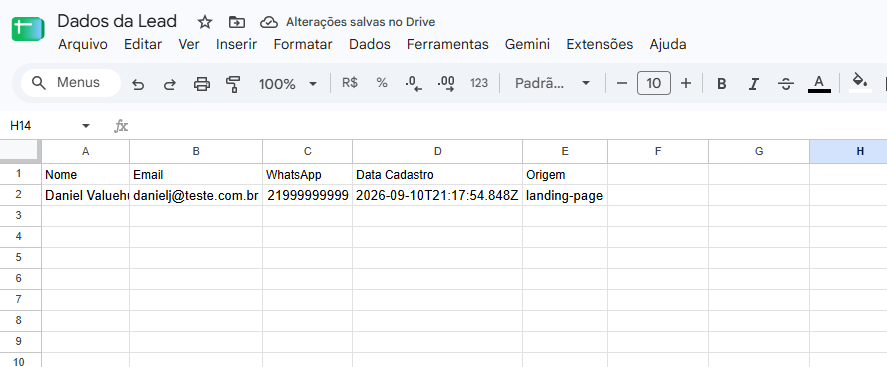
    planilha do Google Sheets com o lead gravado após o teste

    Figura 9: planilha do Google Sheets com o lead gravado após o teste

    Boas práticas e próximos passos

    • Domínio próprio: use um proxy reverso ou o domínio customizado do n8n para que a URL da landing page não exponha /webhook/....
    • Proteção contra spam: considere adicionar um reCAPTCHA ou um honeypot no formulário antes de liberar em produção.
    • Automação pós-cadastro: aproveite o mesmo fluxo para, logo após salvar no Google Sheets, disparar uma mensagem automática de boas-vindas por WhatsApp ou e-mail, ou enviar o lead para um CRM.
    • Múltiplas origens: reaproveite o Bloco 2 (captura e validação) para receber leads de várias landing pages diferentes, apenas variando o valor do campo origem.

    Conclusão

    Esse fluxo mostra como o n8n pode substituir, para casos simples e de baixo volume, ferramentas pagas de landing page e captura de leads. Ao unir dois Webhooks, um nó Code para gerar a interface e outro para validar os dados, e a integração nativa com Google Sheets, é possível colocar uma página de captação no ar em minutos — sem depender de infraestrutura própria e mantendo os dados centralizados em uma planilha simples de acompanhar. É uma base sólida para evoluir depois para automações mais completas, como notificações automáticas, integração com CRM ou disparo de campanhas de WhatsApp.

    Referências

    N8N. Webhook Node Documentation. In: n8n Documentation. Disponível em: https://docs.n8n.io/integrations/builtin/core-nodes/n8n-nodes-base.webhook/. Acesso em: 11 set. 2026.

    N8N. Google Sheets Node Documentation. In: n8n Documentation. Disponível em: https://docs.n8n.io/integrations/builtin/app-nodes/n8n-nodes-base.googlesheets/. Acesso em: 11 set. 2026.

    GOOGLE. Google Sheets API Overview. In: Google for Developers. Disponível em: https://developers.google.com/sheets/api. Acesso em: 11 set. 2026.


    Autor: Daniel J. F. Nunes — https://www.linkedin.com/in/danieljfnunes


    Conheça as formações de IA para negócios para aumentar performance dos negócios

  • Vibe Coding: o que é e como começar sem programar

    Vibe Coding: o que é e como começar sem programar

    Objetivo

    Este artigo explica o que é vibe coding, por que o termo virou palavra do ano em 2025 e, principalmente, como um profissional de negócio — alguém que nunca escreveu uma linha de código — pode usar essa abordagem para construir as próprias ferramentas de trabalho. Você vai encontrar aqui o ciclo de trabalho que faz a técnica funcionar, um método em cinco passos para tirar a primeira ideia do papel, critérios para escolher a ferramenta certa e, com o mesmo peso, os limites reais da abordagem: onde ela quebra, o que ela não resolve e quando insistir nela custa caro.

    A promessa não é transformar você em programador. É outra coisa, e talvez mais útil: permitir que você pare de depender de fila de TI para resolver problemas pequenos e específicos do seu dia a dia.

    O que você precisa para acompanhar

    1. Uma conta em alguma ferramenta de IA generativa que gere aplicações — as opções estão listadas mais adiante, e várias têm plano gratuito.
    2. Um problema real e pequeno do seu trabalho. Não invente um exemplo: use algo que hoje você resolve na mão, com planilha ou copiando e colando.
    3. Disposição para testar o que a IA entrega antes de confiar. Esse é o único pré-requisito que não dá para pular.

    O que é vibe coding

    Vibe coding é um estilo de desenvolvimento de software em que você cria aplicativos conversando com uma inteligência artificial, em linguagem natural, em vez de escrever código linha por linha. Você descreve o que quer — “preciso de uma página que receba nome e e-mail e me avise quando alguém preencher” — e a IA produz o código, os arquivos e a estrutura necessários.

    O termo foi cunhado pelo pesquisador de IA Andrej Karpathy em fevereiro de 2025, em uma publicação no X que, nas palavras do próprio autor, era um pensamento solto disparado sem maiores expectativas. A frase que pegou foi esta: “Existe um novo tipo de programação que eu chamo de vibe coding, em que você se entrega totalmente às vibes, abraça as exponenciais e esquece que o código sequer existe.”

    O que começou como comentário de rede social virou categoria de mercado em menos de um ano. Em novembro de 2025, o Collins Dictionary elegeu vibe coding a palavra do ano, definindo-a como o uso de inteligência artificial para transformar linguagem natural em código de computador.

    O ponto que costuma passar despercebido nessa história é que o vibe coding não democratizou a programação. Ele democratizou a autoria de software. São coisas diferentes, e a distância entre elas é exatamente onde moram os riscos que veremos adiante.

    O que muda no seu papel

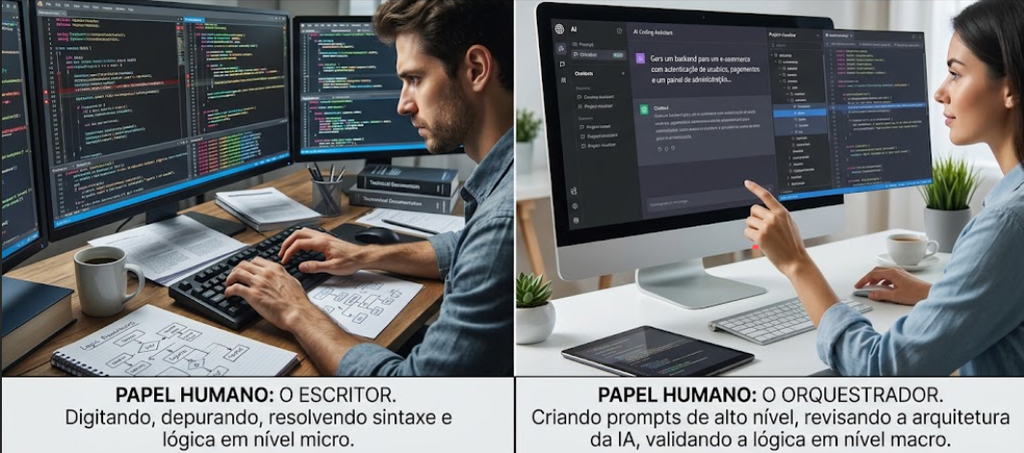
    Na programação tradicional, boa parte do esforço está nos detalhes de implementação: a sintaxe exata, a pontuação, o nome correto de cada comando. O conhecimento exigido é o da linguagem.

    No vibe coding, o esforço se desloca. Você deixa de ser quem digita e passa a atuar como diretor ou orquestrador: quem define o objetivo, julga o resultado e decide o próximo passo. O conhecimento exigido deixa de ser sintaxe e passa a ser clareza sobre o que precisa ser feito — o que, para quem trabalha com processos e regras de negócio, é uma vantagem, não uma limitação. Você já sabe descrever o problema melhor do que muito programador experiente saberia.

    A troca, porém, é honesta e vale dizer com todas as letras: você ganha velocidade e perde visibilidade. O código existe, roda e pode falhar — mesmo que você tenha “esquecido que ele existe”.

    comparação lado a lado entre programação tradicional e vibe coding, destacando o que muda no papel humano

    Figura 1: comparação lado a lado entre programação tradicional e vibe coding, destacando o que muda no papel humano (Gerada por IA modelo Imagen 3)

    Os dois modos de vibe coding

    Esta é a distinção mais importante do artigo, e a que evita a maior parte dos problemas. Na prática, o vibe coding é aplicado de duas formas bem diferentes:

    • Modo exploratório: você confia inteiramente na saída da IA e não revisa o código. É o sentido original de Karpathy — “esquecer que o código existe”. Serve para ideação rápida, protótipos e o que ele chamou de projetos descartáveis de fim de semana, em que velocidade é o único objetivo.
    • Modo profissional: a IA atua como colaboradora, quase uma parceira de dupla. Você orienta, mas revisa, testa e entende o que foi gerado — e assume responsabilidade pelo produto final.

    O erro caro é usar o primeiro modo e tratar o resultado como se fosse o segundo. Um protótipo feito para ser descartado, colocado no ar para clientes reais sem revisão, deixa de ser um atalho e vira um passivo. Antes de começar, decida em qual dos dois modos você está — e mude de modo conscientemente quando o projeto mudar de status.

    Regra prática: se algo vai tocar dados de clientes, dinheiro ou uma decisão que você não pode desfazer, você não está mais no modo exploratório. Ponto.

    O ciclo que faz tudo funcionar

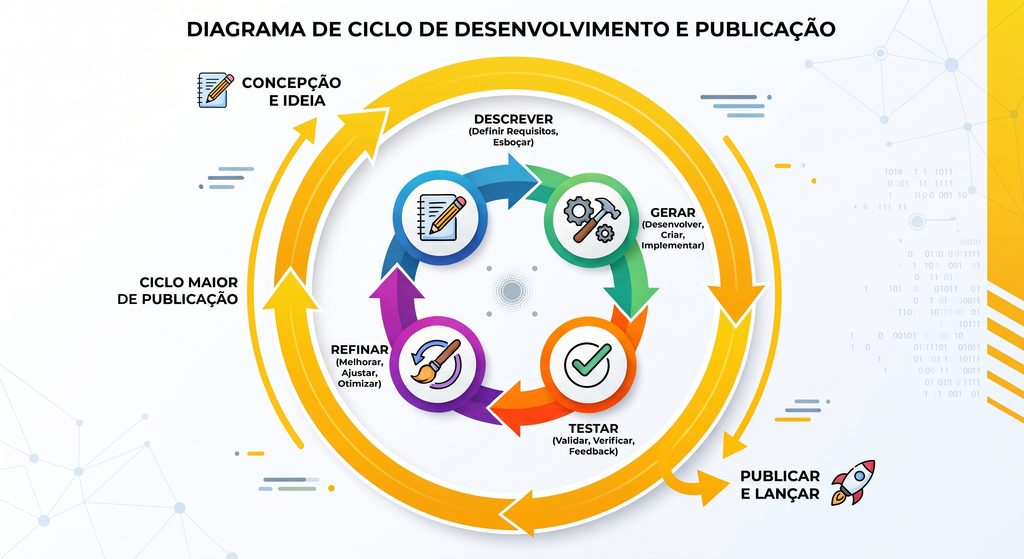
    O vibe coding não é um comando único que produz um sistema pronto. É um ciclo de conversa que se repete até o resultado servir:

    1. Descrever: você explica em linguagem simples o que quer. Ex.: “crie uma página com um formulário de nome, e-mail e telefone”.
    2. Gerar: a IA interpreta o pedido e produz a primeira versão, geralmente com uma prévia visual ao lado.
    3. Testar: você executa e confere se funciona como esperava. Este passo não é opcional — é ele que separa um ciclo de trabalho de uma aposta.
    4. Refinar: se algo está errado ou faltando, você descreve o ajuste. Ex.: “funciona, mas mostre uma mensagem de erro quando o e-mail estiver em branco”.
    5. Repetir até o resultado estar completo.

    Acima desse ciclo pequeno existe um ciclo maior, que é o do aplicativo inteiro: descrever a aplicação completa, gerar a primeira versão com interface e lógica, iterar com pedidos de acompanhamento, revisar com olhar humano — segurança, qualidade, correção — e só então publicar.

    Figura 2: diagrama do ciclo descrever, gerar, testar e refinar em looping, com o ciclo maior de publicação em volta (Gerada por IA modelo Imagen 3)

    Como começar: cinco passos

    Passo 1: escolha um problema pequeno, chato e seu

    A escolha do primeiro projeto define se você vai continuar ou desistir. Procure algo que você faz repetidamente, que tenha regra clara, que não envolva dados sensíveis e que caiba em uma tela: um calculador de comissão, um gerador de proposta a partir de um formulário, um painel que lê uma planilha e mostra os cinco maiores atrasos. Fuja de “um CRM para a empresa” na primeira tentativa.

    Passo 2: escreva o primeiro prompt como um briefing, não como um desejo

    A diferença entre um resultado ruim e um bom está quase toda aqui. Um prompt útil diz para quem, o que entra, o que sai e qual a regra:


    Crie um aplicativo web de página única para calcular comissão de vendedores.
    
    Quem usa: gerente comercial, sem conhecimento técnico.
    Entrada: um formulário com nome do vendedor, valor vendido no mês e tipo de
    contrato (novo ou renovação).
    Regra: contrato novo paga 5% sobre o valor; renovação paga 2%. Se o valor
    vendido passar de 50 mil, some 1 ponto percentual em qualquer um dos casos.
    Saída: mostrar o valor da comissão em destaque e uma linha explicando como o
    cálculo foi feito.
    Visual: limpo, com fundo claro e um botão principal. Precisa funcionar bem no
    celular.

    Repare que não há um único termo técnico no prompt acima — e, mesmo assim, ele é específico o bastante para não sobrar ambiguidade. É esse o trabalho que passa a ser seu.

    Passo 3: teste antes de pedir a próxima coisa

    A tentação é encadear pedidos: “agora adiciona isso, e aquilo, e mais aquilo”. Não faça. A cada geração, rode e confira — inclusive os casos estranhos: campo vazio, valor negativo, texto onde deveria haver número. Erros encontrados cedo custam um prompt; erros encontrados depois de dez camadas custam recomeçar.

    Passo 4: peça o conserto descrevendo o sintoma, não a solução

    Você não precisa saber qual é o defeito. Precisa descrever bem o que viu: “quando deixo o valor vendido em branco e clico em calcular, a tela mostra NaN (“Not a Number”) em vez de uma mensagem”. Descrever o sintoma, o que você fez e o que esperava resolve a maior parte dos casos. Se a IA errar duas vezes seguidas no mesmo ponto, não insista no mesmo caminho: peça que ela explique o que o código faz naquele trecho — entender é mais rápido do que adivinhar.

    Passo 5: revise antes de publicar

    Antes de colocar qualquer coisa no ar, faça três perguntas à própria IA e leia as respostas com atenção: “quais dados esse aplicativo guarda e onde?”, “que partes disso alguém de fora conseguiria acessar?” e “o que quebra se duzentas pessoas usarem ao mesmo tempo?”. Se alguma resposta deixar você desconfortável, é sinal de que esse projeto precisa de alguém técnico antes de ir adiante.

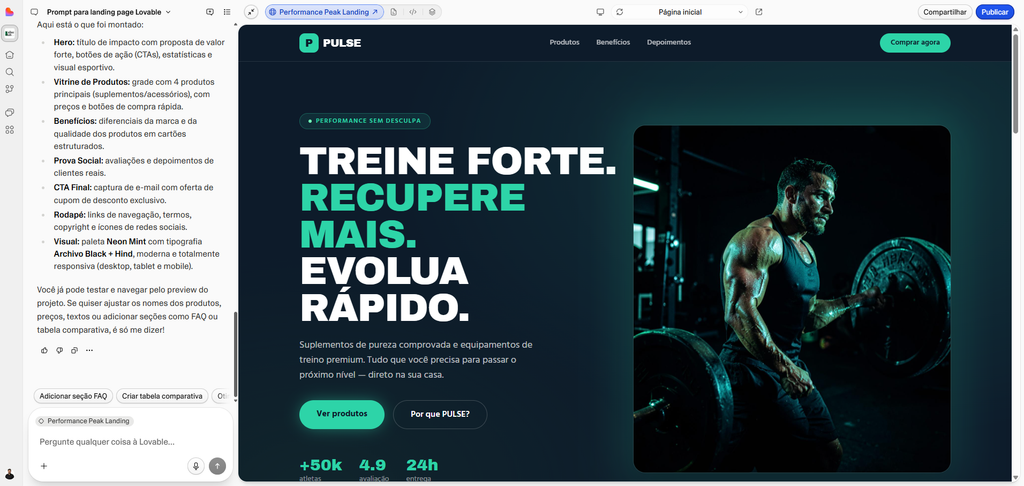
    lovable Value hub

    Figura 3: tela de uma ferramenta de vibe coding com o prompt à esquerda e a prévia do aplicativo funcionando à direita (Aplicação gerada no Lovable)

    Escolhendo a primeira ferramenta

    A escolha depende muito mais do seu objetivo do que do seu cargo. De forma geral, as opções se organizam em três grupos:

    • Para quem não tem experiência técnica: ferramentas que geram o aplicativo completo a partir de uma descrição e publicam com um clique, como Google AI Studio, Firebase Studio, Lovable e Bolt. É por aqui que você deve começar.
    • Para interfaces e páginas: ferramentas focadas em gerar telas e landing pages a partir de uma descrição visual, úteis quando o objetivo é validar uma ideia com usuários reais.
    • Para quem já escreve algum código: assistentes que vivem dentro do editor ou do terminal, como Cursor, Codex e Claude Code, que dão muito mais controle — e exigem muito mais contexto.

    Um conselho que economiza frustração: use uma segunda IA por chat como tradutora. Quando não entender um termo que apareceu (“dependência”, “variável de ambiente”, “publicar em produção”), pergunte em outra janela. Separar a ferramenta que constrói da ferramenta que explica mantém a conversa principal limpa e o seu aprendizado acontecendo.

    Onde o vibe coding quebra

    Esta seção não está aqui para desanimar ninguém. Está aqui porque quem conhece os limites usa a ferramenta por mais tempo.

    • Código que funciona não é código seguro. O relatório 2025 GenAI Code Security Report, da Veracode, testou mais de 100 modelos de linguagem em 80 tarefas de programação e encontrou vulnerabilidades da lista OWASP Top 10 em 45% do código gerado. O estudo também observou que aumentar o tamanho do modelo não melhorou a segurança — ou seja, é uma questão estrutural, não algo que a próxima versão resolve sozinha. Para quem não programa, isso é especialmente relevante: a falha que passa despercebida é justamente a que exigiria raciocínio de segurança para ser vista.
    • A IA não conhece o contexto que você não contou. Ela desconhece suas regras internas, seus acordos com clientes, a norma do seu setor. O que não estiver no prompt não existe para ela — e ela não vai avisar que faltou.
    • Dados pessoais mudam o jogo. No momento em que o aplicativo toca nome, e-mail, telefone ou qualquer dado de cliente, a LGPD se aplica igual, tenha o código sido escrito por uma pessoa ou por uma IA. A responsabilidade continua sendo da empresa.
    • Manutenção é o custo escondido. Um sistema gerado em duas horas que ninguém entende vira dívida técnica no dia em que precisar mudar. Se a aplicação vai durar, alguém precisa entender o que ela faz.
    • Ferramenta de apoio, não muleta. Aceitar tudo automaticamente, sem curadoria, é o caminho mais rápido para um sistema que ninguém consegue sustentar — inclusive você.

    Quando usar e quando usar com maior cautela

    O vibe coding demonstra ser uma ferramenta extremamente vantajosa para acelerar o desenvolvimento inicial de projetos. Sua aplicação é ideal para a criação rápida de provas de conceito, permitindo a validação de ideias junto aos usuários antes de alocações significativas de recursos. Além disso, mostra-se altamente eficaz na estruturação de ferramentas internas, na automação de processos repetitivos para equipes e como um instrumento prático para a capacitação técnica.

    Contudo, é importante adotar uma postura rigorosa ao empregar essa abordagem no desenvolvimento de aplicações profissionais e robustas. Caso o sistema envolva o processamento de dados sensíveis e financeiros, integrações complexas com sistemas legados ou o atendimento a exigências de compliance, o escrutínio em relação à segurança e à validação técnica deve ser redobrado. Nesses cenários críticos, o código gerado por inteligência artificial não deve ser implantado diretamente em produção. Ele permanece valioso como um esboço preliminar que otimiza o fluxo de trabalho, mas que exige, obrigatoriamente, uma revisão humana minuciosa para mitigar o risco de falhas imperceptíveis e danos operacionais.

    Conclusão

    O vibe coding não substitui desenvolvedores, e o julgamento humano segue sendo a parte insubstituível do processo. O que ele faz, e faz muito bem, é derrubar a barreira de entrada: tirar de quem conhece o problema a dependência de quem conhece a sintaxe. Para um profissional de negócio, isso significa poder construir em uma tarde a ferramenta que resolveria um incômodo de meses.

    A recomendação, no fim, é simples: comece pequeno, teste tudo o que a IA entregar, saiba em qual dos dois modos você está trabalhando e trate segurança como parte do processo, não como etapa final. Quem faz isso não vira programador — vira algo mais raro e bem mais valioso dentro de uma empresa: alguém que sabe transformar um problema de negócio em uma solução que funciona.

    Referências

    GOOGLE CLOUD. Vibe Coding explicado: ferramentas e guias. In: Google Cloud. Disponível em: https://cloud.google.com/discover/what-is-vibe-coding?hl=pt-BR. Acesso em: 11 set. 2026.

    KARPATHY, Andrej. There’s a new kind of coding I call “vibe coding”. In: X, 2 fev. 2025. Disponível em: https://x.com/karpathy/status/1886192184808149383. Acesso em: 11 set. 2026.

    COLLINS DICTIONARY. The Collins Word of the Year 2025. In: Collins Dictionary. Disponível em: https://www.collinsdictionary.com/woty. Acesso em: 11 set. 2026.

    VERACODE. 2025 GenAI Code Security Report. In: Veracode. Disponível em: https://www.veracode.com/resources/analyst-reports/2025-genai-code-security-report/. Acesso em: 11 set. 2026.


    Autor: Daniel J. F. Nunes — https://www.linkedin.com/in/danieljfnunes


    Conheça as formações de IA para negócios para aumentar performance


  • RAG com Supabase e n8n. Agente de IA (Atendimento RH)

    RAG com Supabase e n8n. Agente de IA (Atendimento RH)

    Objetivo

    O objetivo deste artigo é apresentar o desenvolvimento e a implementação de um agente inteligente de onboarding para Recursos Humanos, utilizando a técnica de RAG (Retrieval-Augmented Generation) para garantir respostas precisas e fundamentadas nos documentos internos da empresa. A solução proposta integra o Supabase como um banco de dados vetorial escalável para o armazenamento e recuperação de conhecimentos, e o n8n como a camada de orquestração de fluxo de trabalho (workflow), demonstrando como a união dessas tecnologias permite automatizar a integração de novos colaboradores de forma personalizada, eficiente e segura

    Pré-requisitos:

    Para que possamos seguir com esse roteiro de criação de um agente simples que utiliza o RAG para obter informações especifica da sua organização precisamos de uma conta no n8n e no supabase

    1. Cria sua conta no n8n: Post da ValueHub explicando como criar uma conta, caso ainda não tenha criado.
    2. Crie sua conta no supabase: Post da valuehub explicando como criar uma conta no supabase

    Para que possa nivelar o seu conhecimento em relação a técnica de RAG, vou deixar um artigo para que você possa entender entender os fundamentos dessa técnica. Post da ValueHub

    Configurando o Supabase

    • Dentro do projeto em que iremos criar o banco vetorial, selecione a funcionalidade do “SQL Editor” na parte esqueda da tela, conforme imagem abaixo:
    • Execute o script na tela do “SQL Editor”

    -- Habilita  a extensao pgvector para trabalhar com embedding vectors
    CREATE EXTENSION IF NOT EXISTS vector;
    
    -- Cria a tabela para armazenar os documentos
    -- Pode mudar o nome da tabla para sua necessidade, só lembrar de substituir todos os itens da função para o mesmo nome
    create table if not exists documents(
      id bigserial primary key,
      content text, -- corresponds to Document.pageContent
      metadata jsonb, -- corresponds to Document.metadata
      embedding vector(1536) -- 1536 works for OpenAI embeddings, Altere se necessario
    );
    
    -- Create a function to search for documents
    create function match_documents (
      query_embedding vector(1536),
      match_count int default null,
      filter jsonb DEFAULT '{}'
    ) returns table (
      id bigint,
      content text,
      metadata jsonb,
      similarity float
    )
    language plpgsql
    as $$
    #variable_conflict use_column
    begin
      return query
      select
        id,
        content,
        metadata,
        1 - (documents.embedding <=> query_embedding) as similarity
      from documents
      where metadata @> filter
      order by documents.embedding <=> query_embedding
      limit match_count;
    end;
    $$;
    

    Esse script cria todo setup necessário para funcionar a base vetorial no supabase

    Criando o Agente “Meu Onboarding RH”

    “Meu Onboarding RH” é um agente de inteligência artificial projetado para transformar a jornada de integração de novos talentos. Através da tecnologia RAG, ele atua como um assistente consultivo 24/7, capaz de sanar dúvidas sobre benefícios consultando instantaneamente os manuais da empresa para fornecer respostas precisas e contextualizadas.

    Iremos separa a criação do agente em duas etapas. A primeira etapa será a parte de ingestão dos docuemntos e a segunda parte o agente consultando a base de conhecimento para dar as respostas corretas.

    Criando a ingestão de documentos no supabase

    1. Passo: Gatilho de Formulário (On form submission)
      • Adicione o nó n8n Form Trigger.
      • Configure o “Form Title” como “INGESTÃO DE DOCUMENTOS”.
      • Em Fields, adicione um campo:
        • Field Name: “Faça o upload dos seus dados para testar o RAG.”
        • Field Element Type: File.
        • Accept File Types: .pdf.
    2. Passo: O Coração do Fluxo (Supabase Vector Store)
      • Adicione o nó Supabase Vector Store.
      • No campo Action, selecione Insert Documents.
      • Credential to connect with: Conecte sua API do Supabase.
      • Table Name: Digite o nome da tabela criada no Supabase .
      • Importante: Este nó possui duas “entradas” na parte inferior que precisam ser preenchidas pelos nós dos passos seguintes. “Embedding” e “Document”
    3. Passo: Configurar Embeddings
      • Clique no conector circular de entrada chamado Embedding (embaixo do nó Supabase) e procure por Embeddings OpenAI.
      • Credentials: Insira sua OpenAI API Key.
      • O modelo padrão geralmente é o text-embedding-3-small ou text-embedding-ada-002.
    4. Passo: Carregar o Arquivo (Default Data Loader)
      • Clique no conector circular de entrada chamado Document (embaixo do nó Supabase) e adicione o nó Default Data Loader.
      • Em Data Type, selecione Binary (pois o arquivo vem do formulário).

    Figura: Ingestão de documentos no n8n

    Figura: Supabase Base vetorial.

    Criando o agente “Meu Onboarding RH”

    1. Passo: Configuração do Trigger de Interface. O fluxo inicia com o nó “When chat message received”.
      • Tipo: chatTrigger.
      • Objetivo: Capturar a entrada do usuário através de uma interface de chat e iniciar a execução do workflow.
    2. Passo: Conectar o nó de “Agent AI”
      • Adicine uma opção “Options” de “System Message”, para adicionar o prompt de sistemas.
      • Elementos sugeridos para o prompt de sistemas
        • MISSÃO
        • PERSONA & TOM
        • REGRAS & RESTRIÇÕES
        • CONTEXTO & FERRAMENTAS
        • FOMATO DA SAÍDA
    3. Passo: Definição do Modelo de Linguagem (Cérebro)
      • Conecte o nó “OpenAI Chat Model” à entrada Chat Model do agente.
      • Configuração: Utiliza o modelo gpt-4.1-mini ou modelo de sua preferência para processar as solicitações.
      • Credenciais: Requer uma API Key da OpenAI configurada no n8n.
    4. Passo: Implementação da Base de Conhecimento (Ferramenta de Busca)
      • Conector de Vetores: Utilize o nó “Supabase Vector Store ” conectado à entrada Tool do agente.
      • Parametros do “Supabase Vector Store”
        • Credential to connect with (Sua credencial do Supabase)
        • Operation Mode (Retrieve Documents (As Tool for AI Agent))
        • Description (Prompt para identificar o objetivo do Vector Store exemplo: “buscar informações na base de conhecimento de benefícios do RH”
        • Table Name (A tabela criada na etapa de configuração do Supa base vector) é aonde será recuperado as informações
      • Configurar Embeddings
        • clique no conector circular de entrada chamado Embedding (embaixo do nó Supabase) e procure por Embeddings OpenAI.
        • Credentials: Insira sua OpenAI API Key.
        • O modelo padrão geralmente é o text-embedding-3-small ou text-embedding-ada-002.

    Figura: Supabase Base vetorial.

    O Agente está pronto para Ser utilizado

    Conclusão

    A construção deste agente no n8n representa uma solução avançada de IA Generativa aplicada ao RH, integrando o processamento de linguagem natural do modelo GPT-4 com a precisão técnica da arquitetura RAG (Retrieval-Augmented Generation). Ao conectar o nó central do Agente a uma base de conhecimento vetorial no Supabase, o sistema deixa de ser um chat genérico para se tornar um especialista em benefícios capaz de fornecer respostas fidedignas, seguras e contextualizadas para novos colaboradores. Em utilização, o agente atua como um facilitador de onboarding, reduzindo a carga operacional do Departamento Pessoal e garantindo que o colaborador receba informações estruturadas em tópicos, com destaques em termos cruciais e orientações claras para adesão, tudo isso sob rígidas regras de privacidade e fidelidade aos dados da empresa.

    Referências:

    Autor: Daniel J. F. Nunes https://www.linkedin.com/in/danieljfnunes

    SUPABASE. LangChain: Vector Search with Supabase. In: Supabase Documentation. Disponível em: https://supabase.com/docs/guides/ai/langchain?database-method=sql. Acesso em: 5 jan. 2026.

    LANGCHAIN. Supabase: Vector Store Integration. In: LangChain Documentation. Disponível em: https://docs.langchain.com/oss/javascript/integrations/vectorstores/supabase. Acesso em: 5 jan. 2026.

    COPPINGER, Greg. OpenAI Embeddings and Vector Search in PostgreSQL with pgvector. Supabase Blog, 2023. Disponível em: https://supabase.com/blog/openai-embeddings-postgres-vector. Acesso em: 5 jan. 2026.

    ANTHROPIC. Contextual Retrieval. Anthropic Engineering Blog, 2024. Disponível em: https://www.anthropic.com/engineering/contextual-retrieval. Acesso em: 5 jan. 2026.


    Conheça as formações de IA para negócios para aumentar performance dos negócios


  • O que é RAG (Geração aumentada por Recuperação)?

    O que é RAG (Geração aumentada por Recuperação)?

    O que é RAG?

    O RAG (Geração Aumentada por Recuperação) é uma técnica que transforma a maneira como as Inteligências Artificiais operam, permitindo que modelos como o Gemini ou GPT consultem fontes externas e confiáveis antes de formularem uma resposta. Para entender seu impacto, imagine a IA como um estudante brilhante que, apesar do vasto conhecimento, parou de ler as notícias há um ano. Sem o RAG, esse estudante pode “alucinar” ou errar ao ser questionado sobre fatos recentes; com o RAG, ele ganha acesso imediato a uma biblioteca atualizada, pesquisando informações em tempo real antes de responder.

    Embora os Grandes Modelos de Linguagem (LLMs) sejam motores de processamento massivos treinados em volumes gigantescos de dados, eles possuem uma base de conhecimento estática. Em cenários corporativos, onde o sigilo e a atualização constante são cruciais, o uso do RAG torna-se fundamental. Em vez de investir em retreinamentos caros e complexos, essa abordagem integra as bases de conhecimento internas da organização diretamente ao fluxo de trabalho da IA. O resultado é uma solução de alto custo-benefício que entrega saídas precisas, seguras e contextualmente relevantes para o negócio.

    Por que o RAG é importante?

    O RAG tornou-se o padrão ouro na implementação de IA generativa porque resolve as limitações fundamentais dos modelos de linguagem puro (os LLMs). Sem ele, uma IA é como um especialista que confia apenas na memória de longo prazo; com o RAG, ela se torna um especialista com um computador conectado à internet e aos arquivos da sua empresa.

    Aqui estão os três pilares que explicam sua importância:

    1 – Combate às “Alucinações”

    Os LLMs são treinados para prever a próxima palavra mais provável, e não necessariamente para dizer a verdade factual. Quando não sabem uma resposta, eles podem inventar informações que parecem convincentes (alucinações).

    Com RAG: A IA é obrigada a basear sua resposta em um documento específico que o sistema recuperou. Se a informação não estiver lá, ela pode dizer “não encontrei”, em vez de inventar.

    2 – Dados em Tempo Real e Privados

    O treinamento de uma LLM custa milhões de dólares e leva meses. Isso significa que o conhecimento dele tem uma “data de validade”.

    Atualização instantânea: Se a sua empresa mudar uma regra interna hoje, basta atualizar o documento na base de dados. O RAG lerá a versão nova imediatamente, sem que você precise treinar a IA novamente.

    Conhecimento proprietário: Permite que a IA responda sobre seus relatórios de vendas, contratos ou manuais técnicos sem que esses dados sensíveis precisem ser enviados para o treinamento público do modelo.

    3 – Custo-Benefício e Escalabilidade

    Treinar ou fazer o “ajuste fino” (fine-tuning) de um modelo é um processo técnico caro e demorado.

    Eficiência: O RAG é muito mais barato. Você mantém o modelo “de prateleira” e apenas gerencia uma base de dados (geralmente uma Vector Database). Isso permite que pequenas e médias empresas criem assistentes poderosos com baixo investimento.

    Origem do RAG

    O termo e a arquitetura específica do RAG foram formalizados no artigo “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks”, publicado por pesquisadores do Facebook AI Research (FAIR), University College London (UCL) e New York University. O autor principal, Patrick Lewis, é frequentemente creditado como o inventor da técnica.

    O Desafio: Naquele período, modelos como o BART e o GPT-2 já demonstravam fluência na escrita, porém apresentavam limitações críticas em tarefas de “conhecimento intensivo”. A dificuldade residia em acessar fatos precisos e manipular dados específicos, o que frequentemente resultava em alucinações.

    A Abordagem: Para superar essa barreira, a pesquisa mudou o paradigma: em vez de sobrecarregar a memória paramétrica (o conhecimento fixo no peso do modelo), os cientistas introduziram uma memória não-paramétrica. Essa solução funciona como um repositório externo de consulta, permitindo que a IA busque informações em tempo real antes de gerar qualquer resposta.

    Como Funciona

    O funcionamento do RAG pode ser comparado a um processo de “pesquisa de campo” em tempo real. Em vez de a IA responder apenas com o que “decorou”, ela segue um fluxo de trabalho estruturado para buscar, ler e sintetizar informações novas.

    O processo divide-se em duas fases principais: a Preparação dos Dados ou Ingestão (que acontece antes da pergunta) e o Ciclo de Execução (que acontece no momento da pergunta)

    1– Preparação dos Dados (Indexação ou Ingestão)
    Antes de o sistema estar pronto, seus documentos (PDFs, sites, manuais) precisam ser “traduzidos” para uma linguagem que a máquina entenda:

    Segmentação (Chunking): Documentos longos são divididos em pequenos trechos (ex: parágrafos de 500 caracteres).

    Embeddings: Cada trecho é convertido em um vetor (uma lista de números que representa o significado semântico daquele texto).

    Banco de Dados Vetorial: Esses vetores são armazenados em um banco especializado, criando um “mapa de significados”.

    2 – Ciclo de Execução (O passo a passo da resposta)
    Quando você faz uma pergunta, o sistema executa quatro etapas instantâneas:

    Recuperação (Retrieval): O sistema transforma a sua pergunta em um vetor e procura no Banco de Dados Vetorial quais trechos de documentos são numericamente mais “próximos” ou parecidos com a sua dúvida.

    Aumento (Augmentation): Os trechos encontrados são anexados à sua pergunta original. O sistema cria um “super-prompt” que diz à IA: “Aqui está a pergunta do usuário e aqui estão os fatos reais que encontrei. Use esses fatos para responder”.

    Geração (Generation): O LLM (como o Gemini) lê esse conjunto de informações e redige uma resposta fluida e natural.

    Citação (Opcional, mas comum): O sistema pode indicar exatamente de qual documento ou página retirou aquela informação, permitindo a verificação humana.

    Conclusão

    O RAG prova que a inteligência de um modelo não precisa estar limitada ao seu treinamento inicial. Ao oferecer à IA uma ‘biblioteca’ para consulta em tempo real, democratizamos o acesso a assistentes altamente especializados e precisos, sem os custos exorbitantes de retreinamentos constantes. O futuro da interação homem-máquina será construído sobre essa base: modelos que não apenas falam com fluidez, mas que fundamentam cada palavra em fatos concretos e dados de confiança.

    Referências:

    LEWIS, Patrick et al. Retrieval-augmented generation for knowledge-intensive NLP tasks. In: CONFERENCE ON NEURAL INFORMATION PROCESSING SYSTEMS (NeurIPS), 33., 2020, Vancouver. Proceedings […]. Vancouver: Curran Associates, Inc., 2020. Disponível em: https://arxiv.org/abs/2005.11401. Acesso em: 19 dez. 2025.


  • O que é MCP (Model Context Protocol)?

    O que é MCP (Model Context Protocol)?

    O que é MCP (Model Context Protocol)?

    É um padrão aberto criado pela Anthropic (proposto em novembro de 2024) para conectar modelos de IA (como o Claude, Gemini ou ChatGPT) a fontes de dados e ferramentas externas de forma padronizada.

    O MCP atua como um “conector universal”, que podemos comparar com um cabo USB-C. Em vez de programar uma integração específica para cada ferramenta, Slack, Google Drive, bancos de dados, os desenvolvedores usam o MCP para que a IA possa “ler” e “usar” esses sistemas automaticamente.

    Figura 1: Diagrama simplificado da arquitetura do Model Context Protocol. Fonte: ModelContextProtocol.io.

    Quai problemas o MCP Resolve?

    O Model Context Protocol (MCP) atua como um tradutor universal, resolvendo cinco problemas críticos que limitavam o potencial das IAs:

    O MCP acaba com a necessidade de criar integrações personalizadas para cada ferramenta. Antes, cada aplicação de IA exigia um código único para se conectar ao Slack ou GitHub; agora, um único servidor MCP funciona em qualquer modelo compatível, como se fosse um padrão USB-C para dados.

    Figura 2: Representação da analogia do padrão USB-C pra o MCP

    Ele resolve o isolamento das IAs, que antes dependiam apenas de informações estáticas do seu treinamento. Com o protocolo, o modelo ganha acesso em tempo real a arquivos locais, bancos de dados e ferramentas de busca, eliminando a necessidade de copiar e colar textos manualmente no chat.

    O protocolo mitiga riscos de privacidade ao permitir que a IA interaja com dados sensíveis sem que eles precisem ser enviados para a nuvem para treinamento. O controle permanece no servidor local, e a IA acessa apenas o contexto estritamente necessário para realizar a tarefa solicitada.

    Ele substitui prompts gigantescos e ineficientes por chamadas de ferramentas (tools) diretas. Em vez de consumir milhares de tokens tentando explicar um contexto, a IA utiliza o MCP para consultar informações específicas de forma cirúrgica, tornando o processo mais rápido e barato.

    Por fim, o MCP resolve a barreira de entrada para desenvolvedores. Ele simplifica a criação de agentes autônomos complexos, permitindo que uma IA não apenas “fale” sobre um problema, mas execute ações reais, como editar códigos no VS Code ou consultar métricas em um servidor SQL de forma padronizada.

    A Arquitetura MCP: Conectando a Inteligência à Ação

    Para entender como o Model Context Protocol (MCP) funciona, imagine uma tomada universal. Antigamente, cada aparelho precisava de um adaptador diferente para se conectar à energia. O MCP é o padrão que permite que qualquer “cérebro” de Inteligência Artificial se conecte instantaneamente a qualquer “ferramenta” de dados da sua empresa, sem a necessidade de criar integrações complexas e caras do zero toda vez.

    A arquitetura do MCP é composta por três pilares fundamentais que garantem que essa comunicação seja fluida, segura e escalável:

    1. O Host (O Ambiente de Trabalho) O Host é a porta de entrada, o aplicativo onde o usuário interage com a IA. Pode ser o Claude Desktop no seu computador, uma ferramenta de programação (IDE) ou um assistente de IA personalizado da sua empresa. É aqui que o problema é apresentado e onde a solução final é entregue ao usuário.
    1. O Cliente MCP (O Tradutor Inteligente) Pense no Cliente como um intérprete altamente qualificado. Ele vive dentro do Host e sua única função é garantir que o modelo de IA e os sistemas externos falem a mesma língua.
      • Ele entende o que a IA precisa (ex: “Busque os dados de vendas de ontem”).
      • Ele traduz esse pedido para o formato correto do protocolo.
      • Ele gerencia as permissões de segurança, garantindo que a IA só acesse o que o usuário permitiu.
    1. O Servidor MCP (O Conector de Dados) O Servidor é o que dá “poderes” à IA. Ele funciona como um conector leve que “encapsula” seus sistemas atuais (como seu banco de dados, Google Drive ou Slack) e os apresenta para a IA de forma organizada.
      • Segurança: O servidor oculta a complexidade técnica do sistema original, expondo apenas as informações necessárias.
      • Versatilidade: Se você mudar de banco de dados, basta atualizar o Servidor MCP, e todas as suas IAs continuarão funcionando sem interrupção.

    Por que isso importa para o seu negócio? A grande inovação aqui não é apenas técnica, mas operacional.

    Com essa arquitetura:

    • Fim dos Silos de Informação: Seus dados deixam de estar “presos” em sistemas legados e passam a ser contextualmente úteis para a IA.
    • Redução de Custos: Em vez de construir 10 integrações diferentes para 10 ferramentas de IA, você constrói uma única vez seguindo o padrão MCP.
    • Agilidade: Novos dados ou ferramentas podem ser plugados ao ecossistema da empresa em minutos, não semanas.

    O MCP transforma a Inteligência Artificial de um “observador” em um “executor”, permitindo que ela acesse informações em tempo real e utilize as ferramentas da sua empresa de forma padronizada e segura.

    O MCP na Prática: O Caso da “Análise de Satisfação em Tempo Real”

    Imagine que o Diretor Comercial de uma empresa deseja entender por que um cliente importante reduziu suas compras. Sem o MCP, ele teria que pedir relatórios para o TI ou abrir cinco abas diferentes no navegador. Com o MCP, a IA faz o trabalho pesado conectando-se aos sistemas da empresa:

    O Cenário

    O gestor pergunta para a IA: “Analise o caso da conta ‘Empresa X’. Por que o volume de pedidos caiu e o que podemos oferecer para recuperá-los?”

    A Orquestração dos Componentes:

    • O Host (Interface): O gestor digita a pergunta no chat da empresa.
    • O Cliente MCP: Identifica que, para responder, a IA precisará acessar dados reais. Ele “chama” os servidores específicos.

    Os Servidores MCP (Os Conectores):

    • Servidor SQL: A IA busca o histórico de vendas dos últimos 6 meses.
    • Servidor Salesforce/CRM: A IA lê as últimas anotações das reuniões do vendedor.
    • Servidor Zendesk: A IA verifica se houve reclamações técnicas ou tickets de suporte abertos.
    • Servidor Slack: A IA consulta as conversas internas da equipe sobre esse cliente.

    O Resultado Final (A Resposta da IA):

    Identifiquei que a Empresa X reduziu os pedidos porque teve três problemas críticos no suporte técnico em outubro (visto no Zendesk). Além disso, o consultor mencionou no Slack que eles estão expandindo para o Nordeste.

    Recomendação: Ofereça um desconto no novo frete para essa região e agende uma conversa para apresentar nossa nova solução de logística. Quer que eu prepare o rascunho do e-mail?

    Conclusão

    Em resumo, o Model Context Protocol representa um marco na evolução da inteligência artificial ao transformar modelos isolados em sistemas integrados e capazes de agir sobre o mundo real. Ao estabelecer um padrão universal de conectividade, ele não apenas reduz drasticamente a complexidade técnica para desenvolvedores, mas também inaugura uma era de IA utilitária, onde a segurança e a eficiência no acesso aos dados são prioridades. O MCP é, portanto, o alicerce para uma nova geração de agentes inteligentes que não apenas conversam, mas operam ferramentas e sistemas de forma fluida e orquestrada.

    Referências:

    Autor: Daniel J. F. Nunes https://www.linkedin.com/in/danieljfnunes

    MODEL CONTEXT PROTOCOL. MCP Simple Diagram. Disponível em: https://mintcdn.com/mcp/bEUxYpZqie0DsluH/images/mcp-simple-diagram.png. Acesso em: 01 Maio 2025.

    MODEL CONTEXT PROTOCOL. Introduction. [S. l.], 2024. Disponível em: https://modelcontextprotocol.io/docs/getting-started/intro. Acesso em: 01 Maio 2025.

    ANTHROPIC. Introducing the Model Context Protocol. [S. l.], 25 nov. 2024. Disponível em: https://www.anthropic.com/news/model-context-protocol. Acesso em: 01 Maio 2025.

    GOOGLE CLOUD. O que é o Model Context Protocol (MCP)? [S. l.], 2024. Disponível em: https://cloud.google.com/discover/what-is-model-context-protocol?hl=pt-BR. Acesso em: 6 jan. 2026.


    Conheça as formações de IA para negócios para aumentar performance.


  • Criando sua conta no supabase

    Criando sua conta no supabase

    A criação de um novo usuário no Supabase é um processo bem direto exigindo apenas um e-mail e uma senha do lado do cliente para registrar o usuário no seu banco de dados e sistema de autenticação, o que é seguido por um e-mail de confirmação que o próprio Supabase gerencia para verificar o endereço do novo usuário, garantindo uma autenticação rápida e segura.

    Siga os passos abaixo

    1- Criando Conta no supabase (https://supabase.com/)

    1.1 Inicie o cadastro da nova conta no “Started your project” na tela inicial (https://supabase.com/)
    1.2 Você será redirecionado para uma tela de “Sign in” e “Sign Up Now”. Acesse o link Sign Up Now abaixo do botão verde de “Sign in” para habilitar os campos de criação de usuário.
    1.3 Adicione seus dados de email e senha na tela de e crie o usuário no botão “sign-up” https://supabase.com/dashboard/sign-up.
    1.4 Faça o processo de checagem de email para confirmar a sua conta
    1.5 Após confirmação, você será redirecionado para tela de criação de nova Organização. Conforme tela abaixo:

    obs: adicione as informações da sua organização, os dados da tela abaixo são meramente ilustrativos.

    1.5 Crie o novo projeto conforme tela abaixo:

    Para que inicie o desenvolvimento do seu banco de dados, será necessário a criação de um projeto.

    Obs: Crie um projeto com sua infomações. Os dados abaixo são meramente ilustrativos

    1.6 Projeto pronto para ser utilizado

    Conclusão

    A partir de agora você já consegue utilizar o supabase e conectar nas suas aplicações de IA

    Referências:

    Autor: Daniel J. F. Nunes https://www.linkedin.com/in/danieljfnunes

    Site da Supabase: https://supabase.com/


    Conheça as formações de IA para negócios para aumentar performance.


  • Criando uma conta de teste no n8n

    Criando uma conta de teste no n8n

    Quer simplificar seu fluxo de trabalho e conectar seus aplicativos favoritos sem precisar de código? O n8n é a ferramenta de automação perfeita para você!

    Neste post, você aprenderá o passo a passo completo para criar sua conta no n8n. Mostraremos como configurar tudo rapidamente.

    1- Criando Conta no n8n (https://n8n.io/)

    1.1 Inicie o cadastro da nova conta no “Get Started” na tela inicial (https://n8n.io/)
    1.2 Preencha o cadastro do formulário de criação de conta e inicie o teste de 14 dias no botão “Start free 14-day trial“
    • O campo “Account name” é o nome que você irá dar para o seu espaço do n8n. A url para chamar seu ambiente será {Account name}.app.n8n.cloud
    1.3 Responda as 5 perguntas para finalizar o cadastro:

    Tradução Literal

    • “[1/5] Tamanho da sua empresa?”
    • “[2/5] Qual time você apoia?”
    • “[3/5] O que melhor descreve sua empresa?”
    • “[4/5] Qual destas opções você se sente confortável em fazer?”
    • “[5/5] Como você ficou sabendo do n8n?”

    1.4 Responda a pergunta:

    “Quais aplicativos você planeja usar?” Tentaremos ajudar você a começar com algumas sugestões de fluxo de trabalho.

    Selecione os aplicativos que deseja ou aperte “Skip” para continuar”

    1.5 Etapa: Convide membros da equipe para seu espaço de trabalho.

    Convide alguém para o seu board ou ou aperte “Skip” para continuar”

    1.6 Seu espaço de trabalho está pronto! Comece a automatizar. “Start automating”
    1.7 Ambiente pronto para automatizar e criar os seus agentes de IA

    Conclusão

    Ambiente do n8n pronto para criar automações


    Conheça as formações de IA para negócios para aumentar performance.